問題建模與資料
把真實問題轉成目標、限制與可用資料,檢查資料品質及方法的前提。
兩個方向,各自深入
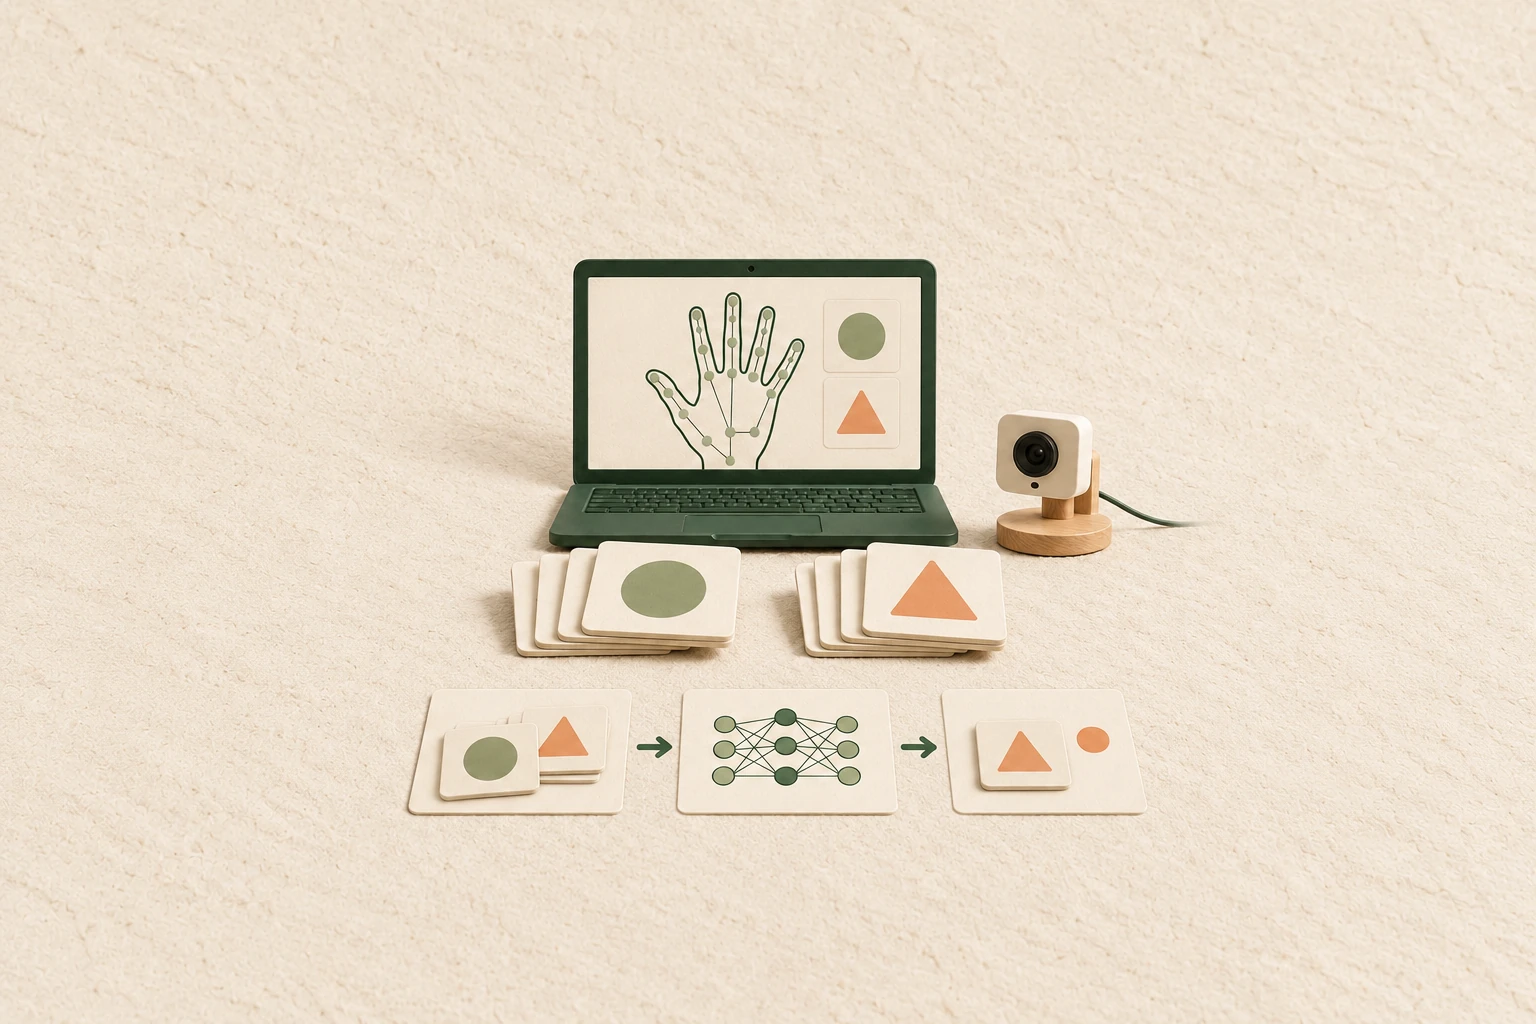
演算法方向著重問題建模與效率;AI 方向著重資料、模型與評估。兩者並列,依先備能力銜接。
AI 與思考能力同步成長
把真實問題轉成目標、限制與可用資料,檢查資料品質及方法的前提。
演算法方向實作最佳化與機器學習核心;AI 方向進行特徵處理、模型訓練及效能評估。
用一致條件比較結果,分析錯誤與限制;AI 方向進一步保存模型並提供可呼叫服務。
規劃中的學習延伸
平行選擇 · 依先備能力確認
把解題方法用在可以描述、測量與比較的問題。學生學習將路徑、排程與資源限制轉成模型,選擇適合的演算法,再以測試與效能實驗檢查。後段選一種簡單機器學習演算法拆解實作,理解方法成立的假設和限制。
國中至高中,通常銜接 L6 檢定班,或具同等資料結構、遞迴、圖搜尋與 C++/Python 能力者。參考內容分為四學期各 20 堂,共約 80 堂。依演算法方向的先備能力安排,不以年級作為唯一分班依據。
每學期 20 堂,以下列出各堂次區段的學習內容。
課程內容將隨 AI 與科技發展,以及班級學習程度適時調整。本課綱僅供參考,教師將依實際教學情況酌情運用與調整。
以小型問題觀察程式與數學先備,補足 Python 資料整理、圖表和測量紀錄。
比較圖的鄰接表/矩陣、堆積及優先佇列;寫出操作測試,分析空間與時間成本。
實作或深入追蹤適合的路徑方法,處理不可達;明示邊權條件,避免用錯演算法。
以最小生成樹、拓撲排序等代表問題學習圖結構;依程度擇定核心題,先理解再擴展。
整理少量經測試的可重用實作,附前置條件、複雜度與反例,不只是收集程式模板。
從基礎比對出發,依題目學習 Trie 或 KMP;用重複字串與不同長度測試。
比較狀態定義及重複子問題,分析記憶體需求;對小案例做暴力對照。
固定資料、環境與重複次數,記錄執行時間及輸入規模;區分偶然快與可重複改善。
根據量測找瓶頸,調整容器、配置或計算順序;不以難懂技巧換取未測量的提升。
對同一功能比較兩種方案,提供正確性測試、圖表、環境與適用範圍。
使用虛構任務或地圖,定義成本、限制及目標;辨認模型省略了哪些真實因素。
從小規模枚舉建立對照,再以貪心或局部搜尋處理較大問題;不把啟發式結果稱為保證最佳。
按題目及先備選一項深入,理解狀態/容量/約束;不要求一次精通所有類型。
改變任務數、限制或初始條件,觀察成本和運行時間;說明方法何時不適合。
完成小型路徑或排程工具,交代輸入、策略、測試、結果與限制。
選 K-Means、簡單決策樹或線性模型其中一種;補足距離、平均或誤差所需的數學。
用小資料手算與程式對照,寫出停止條件與錯誤處理;允許數值工具,不直接呼叫完整同款演算法。
與函式庫結果比較時對齊資料、設定和評估方法,記錄隨機性與版本;解釋差異。
改一個設定、資料條件或實作方式,提出假設,保留基準與完整結果。
他人依說明重跑,展示結果及失敗案例;完成短報告與個人程式講解。
AI 可協助找反例、理解文件和形成實驗想法,但程式正確性、證明與效能結論必須有可查證依據。成果為經測試的演算法工具集、最佳化模擬與一項研究小專題;可以沿同一題目累積。不宣稱修完即具有碩士或專業工程師能力。
能將問題建模,提出可驗證的解法,比較成本與限制,並讓他人重跑至少一個實驗。可依題目進 L8,或繼續深化特定演算法/競賽方向。若轉向 AI 系統,另補資料切分、模型評估與安全的服務整合。
平行選擇 · 依先備能力確認
從提出可回答的資料問題開始,經過整理、建立基準、訓練與測試,完成一個能說明限制的 AI 小系統。學生同時認識傳統機器學習與生成式 AI 的不同用途。每個題目都要回答:需要哪些資料、如何確認沒有偷看答案、結果是否比簡單方法更好,以及什麼情況應停止或交人確認。
國中至高中,完成 L6 任一路線或具同等 Python、資料處理與專題能力者。入班前觀察函式、資料表、圖表、比例與平均等先備能力,依需要安排橋接。參考內容分為四學期各 20 堂,共約 80 堂。主要使用 Python、Pandas、視覺化工具與 scikit-learn;深度學習框架只選一種入門,不要求同時學 PyTorch 和 TensorFlow。
每學期 20 堂,以下列出各堂次區段的學習內容。
課程內容將隨 AI 與科技發展,以及班級學習程度適時調整。本課綱僅供參考,教師將依實際教學情況酌情運用與調整。
選非敏感公開資料,定義預測或分析問題;建立簡單規則或平均值基準,確認是否真的需要 AI。
以 Pandas 整理型別、缺漏與重複,記錄每次處理理由;避免把看似異常但合理的資料隨意刪除。
檢視分布、群組和關係,練習平均、比例及變異;不把相關當成因果。
區分訓練、驗證與最終測試;以容易看懂的案例發現答案混入特徵或重複樣本跨組。
提交問題、來源、處理、圖表與基準;另一位同學依步驟重跑,指出尚不能回答的問題。
建立簡單數值預測,觀察誤差與基準差異;不要把訓練資料表現當泛化效果。
使用決策樹等入門方法,理解特徵、標籤與預測;查看混淆矩陣,辨認不同錯誤的意義。
改變模型複雜度,對照訓練和驗證表現;依題目認識交叉驗證,不反覆查看最終測試來調整。
比較單一準確率和其他適合指標,檢查不同資料條件;描述資料偏差,避免無依據的公平宣稱。
對非敏感資料完成模型,與基準公平比較,展示錯誤案例與不適用範圍。
以 K-Means 等方法觀察相似性;比較尺度與群數,理解分群不等於發現客觀的人群標籤。
用小型範例理解參數、損失、更新與訓練;先觀察行為,再按程度補足必要數學。
用已授權、非人臉的圖像資料建立小模型或遷移學習;分清預訓練部分和學生自行完成的部分。
改變背景、亮度或資料來源,觀察表現下降;討論應補資料、改方法或限制用途。
完成小模型與簡單方法的比較,提交資料說明、測試、結果及可重現環境。
比較分類器與文字生成工具;定義有範圍的整理或問答需求,先建立人工可判讀的測試案例。
使用教師整理且可用的知識資料,先做搜尋,再觀察引用資料輔助回答;區分找到來源與答案真的受支持。
測試找不到答案、來源矛盾與資料中的誤導指令;建立不確定就不作結論及人工確認機制。
模型預測服務或有來源的問答擇一,以校方管理的本地/受控環境整合;記錄品質、時間、成本與資料流向。
用固定測試比較版本,展示成功和失敗案例、操作說明、模型/資料版本與使用限制。
學生同時學習「用 AI 幫忙開發」與「評估自己製作的 AI 系統」,兩者分開記錄。API 服務、資料集及模型授權由校方先評估,必要時用離線或模擬方式替代。不能用真實同學資料做能力、健康或情緒分類,不將教學原型用於高影響決策。外部資料與網頁中的文字不應當成系統指令。
作品可包含資料探索、預測模型及系統整合,並以同一個主題逐步深化。一般性能指標只說明該次資料與測試條件,不推論能可靠處理所有真實場景。
能說明資料來源及切分理由,提出基準、避免明顯資料洩漏、比較模型、解釋錯誤與限制,並重跑實驗。可依題目進 L8 的 AI 應用或研究方向;若數學或軟體基礎不足,先補相應能力,不用工具操作熟練度代替研究準備度。
選課前,先聊清楚
依演算法或 AI 方向確認程式、資料與專題先備能力。 年段可以參考,實際起點請老師依已有能力和目標確認。
依方向研究演算法與最佳化,或完成資料整理、模型訓練、評估與部署的 AI 專題。 本頁列出主要方向與課程大綱,實際內容會依先備和班級安排調整。
常態班試聽免費。想預約試聽,請透過 LINE 洽詢。先與老師討論目前經驗,再確認當期班級與正式課程費用。參考課綱的內容單元不直接等於當期售課堂數。
LINE 洽詢NEXT STEP
帶著目前的程式經驗與想法,與老師討論學習方向。